Open-source ИИ по-китайски: мы пользуемся — они владеют?


Китайские DeepSeek, Qwen и GLM стали для российского бизнеса главной альтернативой ушедшим западным вендорам. Лицензия MIT позволяет дообучать их бесплатно — и многие компании уже перешли на эту экосистему. Но у щедрости Пекина есть обратная сторона: открыв коды сегодня, завтра Китай может их закрыть. И тогда Россия рискует остаться не партнером-разработчиком, а «цифровым покупателем» без права на собственный технологический путь.
Тезис 1. Стратегия «окна возможностей»: Китай уже взял свое
Первый этап (2023–2025) Китаю был нужен не для альтруизма, а для захвата глобального стандарта. Открыв DeepSeek, Qwen и другие модели, он позволил стартапам и корпорациям по всему миру «подсесть» на свою экосистему. По данным Yandex Cloud AI Studio, среди зарубежных решений по потреблению токенов в России лидирует именно Qwen с долей 21,2%, на втором месте — DeepSeek с 13,5%.
DeepSeek использует лицензию MIT, которая разрешает неограниченное коммерческое использование. Но стратегия может измениться, когда модели завоюют критическую аудиторию. И намеки уже есть: с 17 августа 2026 года DeepSeek поднял цены на API-доступ к V4-серии, вводя пиковые тарифы. Стоимость возрастает от 50% до 1100% по сравнению с прежними сверхнизкими расценками (в зависимости от типа тарифа — входные/выходные токены, пиковые/стандартные часы). Пока это монетизация доступа, а не кода. Но тренд очевиден.
Россия, которая активно использовала эти открытые коды, чтобы заменить ChatGPT, рискует оказаться в технологическом капкане: ресурсы уже вложены, но дальнейшее развитие может потребовать «китайской визы».
Тезис 2. Иерархия «старший брат — младший брат», и Россия как поставщик данных
Китай вряд ли допустит возникновение в Евразии второго центра ИИ-компетенций. Для него Россия — не более чем гигантский поставщик сырых данных (языковых, поведенческих, индустриальных) и рынок сбыта облачных мощностей.
Китайские гиганты готовы предоставлять облачные сервисы, но не готовы делиться методологией тренировки фундаментальных моделей. Любая попытка России создать собственного конкурента будет встречена не санкциями (это политически некрасиво), а демпингом цен и бесплатными облачными грантами — чтобы убить российского конкурента на корню.
Тезис 3. «Открытость» как оружие: стандартизация без прав
Когда Китай открывает коды, он фактически навязывает миру свою архитектуру — фреймворки, форматы данных, подходы к оптимизации. Россия, дообучая эти модели на своих датасетах, автоматически попадает в китайский технологический мейнстрим.
На Всемирной конференции по искусственному интеллекту (WAIC) в июле 2026 года российская делегация впервые представила собственный «Российский центр ИИ» (Russian Connected AI Hub) с решениями на базе отечественных моделей. В экспозицию вошли антропоморфный робот Грин на платформе Green-VLA, мультимодальная модель GigaChat 3.5 Ultra и платформа агентной экономики GigaNetwork. Как заявил первый зампред правления Сбербанка Александр Ведяхин, «технологический суверенитет остается общим приоритетом... совместимость стандартов позволит национальным системам работать в единой логике, сохраняя независимость».
Однако на практике «совместимость» пока означает стандарты китайских вендоров. Риски тоже просматриваются: в случае обострения отношений Китай в любой момент может ужесточить лицензию или перекрыть каналы обновлений.
Тезис 4. Игра на опережение: Китай инвестирует в Россию… и еще в свой карман
Китайские вендоры активно заходят в Россию. В 2025 году открыт Китайско-российский инновационный центр трансфера технологий ИИ (с участием ИСП РАН и Шаньдунского центра компьютерных наук). Директор ИСП РАН академик Арутюн Аветисян отметил: «Технологическая независимость может быть только в кооперации». Ему вторит директор по развитию технологий ИИ «Яндекса» Александр Крайнов: «В последние годы Китай перехватывает лидерство в области опенсорса. Создание общих больших опенсорсных продуктов — важная часть сотрудничества».
За этими заявлениями стоит прагматичный расчет. Вопрос в том, кто и кому передает технологии и на каких условиях. Китай предлагает доступ к моделям и данным, но контроль над ключевыми промышленными данными оставляет за собой. Через 3–5 лет, когда китайские решения станут критически важными для инфраструктуры нашей страны, российские разработчики рискуют превратиться в обслуживающий персонал, а не в равноправных партнеров.
Тезис 5. Холодный прагматизм вместо вражды
В отличие от Запада, Китай вряд ли введет санкции против российского ИИ. Но стратегического трансфера технологий ожидать тоже не стоит. Китай будет делать все, чтобы российские модели отставали от китайских на поколение-полтора. Глава Сбера Герман Греф подтвердил: российские модели отстают от американских на год, от китайских — на 6–8 месяцев. Причина — не кадры, а вычислительные мощности. Для обучения конкурентоспособной модели может потребоваться кластер из 100 тыс. ускорителей Nvidia B200, строительство которого Греф оценил в 1–2 трлн рублей. Такой инфраструктуры в России пока не создано.
Однако оценки Грефа — тоже не бесспорная истина, скорее — часть конкурентной борьбы. Выступая в Совете Федерации 17 июля 2026 года, он заявил, что в России осталась только одна полностью отечественная фундаментальная модель — от Сбера. А «Яндекс», по его словам, якобы не создает модель с нуля, а дообучает китайскую Qwen. «Яндекс» тут же опроверг его: компания продолжает самостоятельно разрабатывать фундаментальные модели и не зависит от сторонних решений. Qwen действительно доступна в Yandex Cloud AI Studio с 2025 года, но присутствие китайской модели на облачной платформе не означает, что на нее «посадили» всю «Алису». По словам пресс-службы «Яндекса», компания параллельно развивает семейство YandexGPT, история которого началась еще в 2023 году. Публичный обмен заявлениями между двумя гигантами стал одним из эпизодов конкурентной борьбы в российском ИИ.
Сбер планирует за три года (2024–2026) вложить в генеративный ИИ около 600 млрд рублей. В 2024 году — около 100 млрд, в 2025-м — 150 млрд, в 2026-м — уже 350 млрд. Но эти деньги уходят в основном на инференс — эксплуатацию готовых сетей, а не на обучение. Мощностей всех российских ЦОДов сейчас недостаточно для создания моделей мирового класса. Законодатели, осознавая этот разрыв, предложили считать «большой моделью» систему уже от 1 млрд параметров, тогда как флагманская DeepSeek V4‑Pro оперирует 1,6 трлн.
Вместо прямого лобового состязания с моделями класса GPT-5 российская индустрия (Яндекс, Сбер, Т-Банк) вынужденно делает ставку на компактные модели, локальные суперкомпьютеры и суверенный софт. Основной фокус сегодня — суверенитет в B2B, дообучение под бизнес-ниши и экспорт на Глобальный Юг. Но все эти усилия пока не позволяют говорить о конкуренции на равных в обозримом будущем.
Искусственный интеллект как фактор геополитического влияния
Есть еще один важный ракурс, который обычно ускользает от внимания «технарей». Сегодня вопрос о том, кто контролирует ключевые платформы, неотделим от вопроса, кто формирует глобальные нарративы. Как справедливо замечает официальный представитель МИД России Мария Захарова, «искусственный интеллект становится не столько инструментом прогресса, сколько рычагом давления, средством перераспределения власти в мире».
Один пример: в своей статье об «эффекте страны происхождения ИИ» израильский эксперт Илан Манор (Ilan Manor) приходит к показательному выводу: генеративные модели из США, Европы и Китая дают принципиально разные ответы на один и тот же вопрос (CPD Blog, 10.09.2025).
Эксперимент с запросом о причинах поддержки США действий Израиля в секторе Газа это подтверждает. Американские ChatGPT и Copilot делают акцент на стратегическом альянсе и интересах безопасности. Европейская Mistral — на «дипломатическом прикрытии» в ООН и моральных аспектах. Китайская DeepSeek связывает поддержку с падением легитимности США на Глобальном Юге и религиозным влиянием в американской политике.
Меняется картина и при обсуждении украинских событий. Например, тот же DeepSeek подчеркивает, что, помогая Киеву, Вашингтон снижал зависимость Европы от российских энергоресурсов и тем самым укреплял ее «долгосрочную экономическую независимость».
Другие примеры приводит исследование Манора и Сегава (Policy & Internet, 2025) — оно демонстрирует, что ИИ-алгоритмы могут воспроизводить и усиливать устоявшиеся геополитические стереотипы, формируя заведомо неравное восприятие разных регионов мира.
Сегодня очевидно: любая модель выступает проводником мировоззрения и ценностей страны-разработчика. При этом доверие к «умным машинам» растет, и пользователи нередко воспринимают их ответы как более объективные, чем статьи в СМИ, которые они порой считают ангажированными. «Авторитет алгоритма» становится элементом «мягкой силы 3.0». В этом контексте китайская стратегия открытых кодов — не столько технологический, сколько цивилизационный проект страны, претендующей на роль одного из центров многополярного мира.
Кто виноват и что делать?
Закрытие кодов — совсем не гипотетический сценарий. Эксперты уже выделяют три фактора, способных ускорить его: рост затрат на зарубежные модели, замедление прогресса собственных решений Китая или стратегический разворот России в сторону своей инфраструктуры.
Третий вариант — конечно, самый затратный, но оптимальный для России. Однако отдельной государственной программы по развитию ИИ с необходимыми бюджетами сегодня нет. Есть разрозненные меры поддержки — например, правительство утвердило перечень из 24 особо значимых проектов по импортозамещению ПО общей стоимостью 14,4 млрд рублей. Кабинет министров прорабатывает увеличение грантового софинансирования с 50% до 80% для наиболее критических проектов с использованием ИИ. Эти суммы, очевидно, не покрывают масштаб задачи.
Недавно принятый «закон об ИИ» — еще один показательный пример. «Семь дней, которые взломали ИИ-регулирование» — подробный разбор этого документа вышел на PLUSworld. Что скрывает рамочный закон? Он закрепляет базовые понятия и принципы, но все конкретные требования — к безопасности, порядок подтверждения соответствия, меры поддержки — оставляет «за скобками». Все это будет прописано в подзаконных актах, и как и кем они будут написаны — пока неизвестно. Закон проигнорировал даже агентный ИИ (о котором Греф в Совете Федерации заявил как о главном вызове) — в тексте закона он не упоминается. Итоговая версия заточена исключительно под большие фундаментальные модели (БФМ, более 1 млрд параметров), малые компании и прикладные разработчики тоже остались «за скобками». По сути, нынешняя регуляторика не столько помогает рынку, сколько закрепляет статус-кво крупнейших корпораций.
Мнение PLUSworld
Для банков, финтеха и ритейла сказанное выше означает: цифровой рубль, платежные системы, антифрод-решения, биометрия — все это в ближайшие годы будет опираться на ИИ. Если фундамент этого ИИ — китайские модели с открытым кодом, которые завтра могут стать закрытыми, мы рискуем получить системный риск на уровне национальной платежной инфраструктуры, а следовательно, как минимум и платежного суверенитета России.

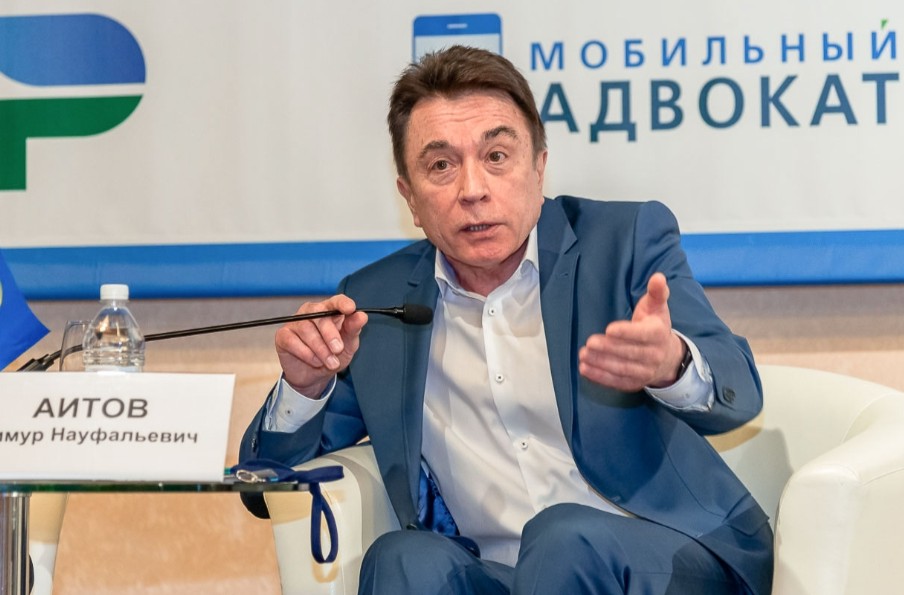
Тимур Аитов не раз говорил о технологическом суверенитете как о более емком и широком понятии, чем импортозамещение. Суверенитет предполагает развитие собственных фундаментальных исследований и прикладных разработок при сохранении открытости к международному взаимодействию. Найти баланс между этими двумя векторами — непростая задача на ближайшие годы. В случае с ИИ это значит: не использовать китайские модели «как есть» и форсировать разработку собственного фундаментального ИИ с нуля, даже если это будет дороже и дольше. Иначе мы рискуем стать цифровой колонией без права на собственный технологический путь.